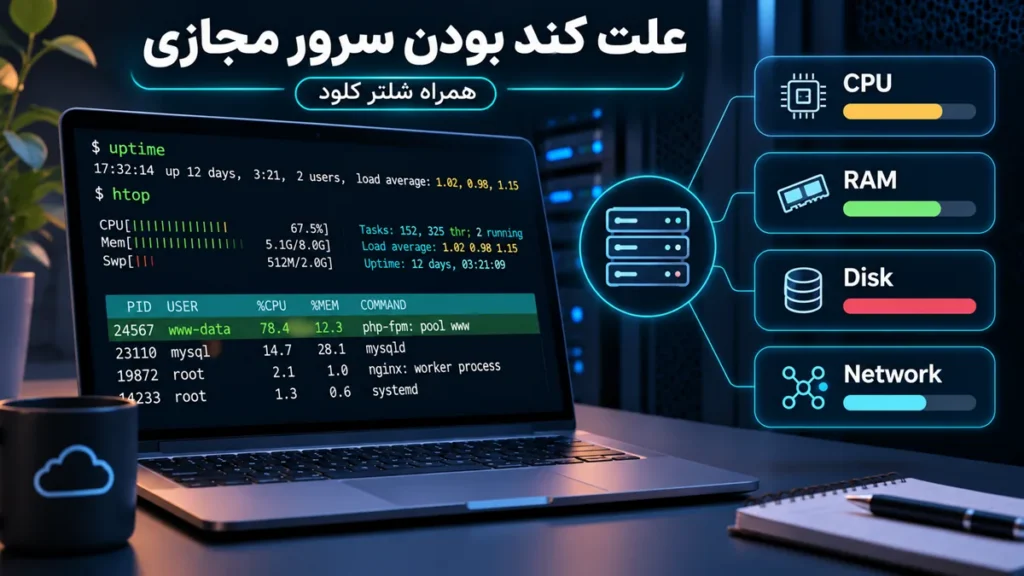
وقتی سرور مجازی کند میشود، پیش از هر تغییری باید بدانید کدام یک از چهار منبع تمام شده است: پردازنده، رم، دیسک یا شبکه. هر چهار حالت از بیرون شبیه هم دیده میشوند — سایت دیر باز میشود — ولی راهحلشان کاملاً متفاوت است و حدس زدن یعنی چند ساعت تغییر بینتیجه.
این مقاله یک ترتیب تشخیص میدهد که از سریعترین بررسی شروع میکند و در هر قدم یک احتمال را رد میکند.
قدم اول: ۳۰ ثانیه برای فهمیدن سمت مشکل
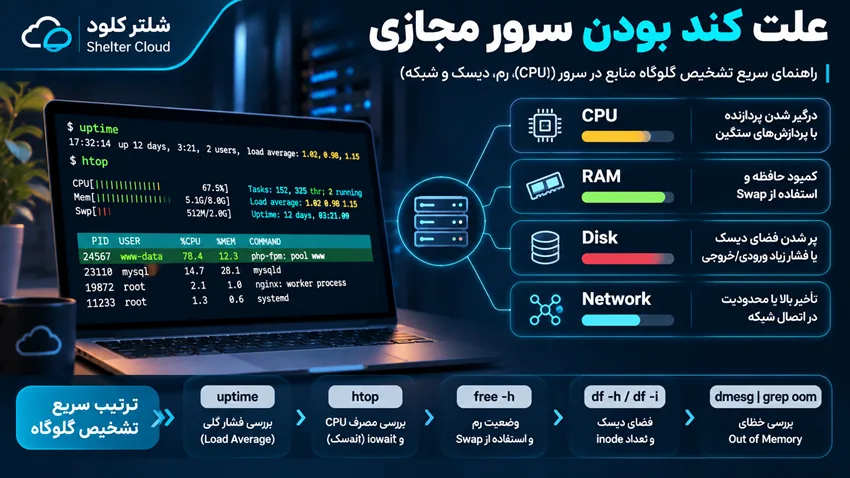
با uptime شروع کنید. سه عددی که بهعنوان load average میدهد میانگین بار یک، پنج و پانزده دقیقهٔ گذشته است. قاعدهٔ خواندنش: این اعداد را با تعداد هسته و منابع پلن سرور مقایسه کنید. روی یک سرور دوهسته، لود ۲ یعنی ظرفیت کامل و لود ۸ یعنی صف طولانی.
نکتهٔ مهمی که معمولاً گم میشود: لود بالا همیشه یعنی پردازنده مشغول نیست. فرایندهایی که منتظر دیسکاند هم در این عدد شمرده میشوند. پس لود ۱۰ ممکن است مشکل CPU باشد یا مشکل دیسک، و قدم بعد همین را جدا میکند.
با top یا بهتر htop به ستونهای بالای صفحه نگاه کنید. مقدار wa یا iowait اگر قابلتوجه است، سرور منتظر دیسک است نه پردازنده. اگر us بالا باشد، یک فرایند واقعاً CPU میخورد.
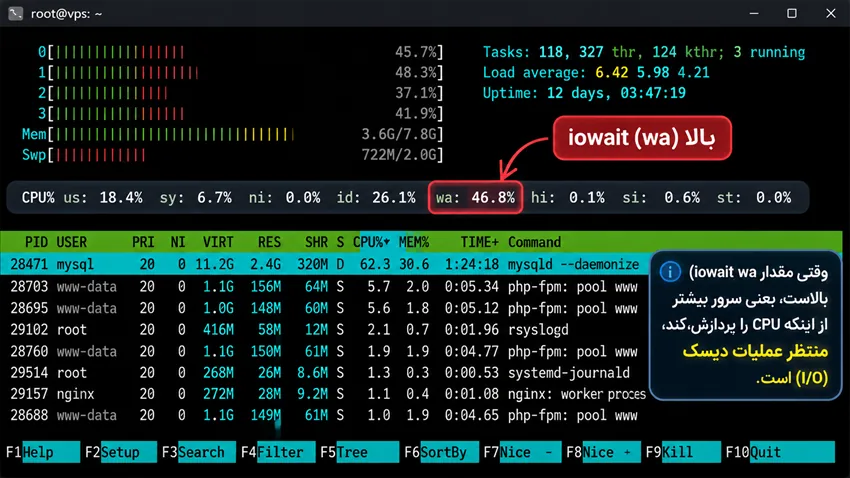
اگر پردازنده پر است
در htop فهرست را بر اساس CPU مرتب کنید و ببینید کدام فرایند بالاست. سه حالت رایج:
- یک پراسس PHP یا پایتون روی ۱۰۰ درصد مانده. معمولاً یک حلقهٔ بیپایان یا یک درخواست سنگین. لاگ همان سرویس را در زمان شروع مشکل ببینید.
- چند پراسس وبسرور همزمان مشغولاند. ترافیک واقعی یا ربات. لاگ دسترسی وبسرور نشان میدهد کدام.
- فرایندی با نام ناشناس. این را جدی بگیرید؛ روی سروری که رمز ضعیف یا سرویس باز داشته، احتمال ماینر نصبشده واقعی است. مسیر فایل اجرایی و زمان ایجادش را بررسی کنید.
اگر رم تمام شده
با free -h نگاه کنید، اما نه به ستون free. در سرور مجازی لینوکس، رم آزاد کم طبیعی است، چون سیستم رم بیاستفاده را به کش فایل میدهد و هر وقت لازم شود پس میگیرد. عددی که اهمیت دارد ستون available است و مصرف swap.
اگر swap در حال استفادهٔ مداوم است، سرور واقعاً رم کم دارد و چون swap روی دیسک است، همین باعث بالا رفتن iowait و کندی عمومی میشود.
حالت شدیدترش خطای Out of Memory است: هستهٔ لینوکس برای نجات سیستم یک فرایند را میکشد. اگر سرویسی بیدلیل قطع شده، با dmesg -T | grep -i oom یا در لاگ سیستم ببینید چه چیزی کشته شده. معمولاً قربانی MySQL است، چون بیشترین حافظه را گرفته — ولی مقصر چیز دیگری است که حافظه را بالا برده.
دو راه واقعی: مصرف را کم کنید (محدود کردن تعداد ورکرهای PHP، تنظیم و کانفیگ بافرهای MySQL) یا رم را بالا ببرید. افزودن swap مشکل را پنهان میکند و سرعت را پایین میآورد؛ بهعنوان حاشیهٔ امنیت خوب است، بهعنوان جایگزین رم نه.
اگر دیسک پر شده
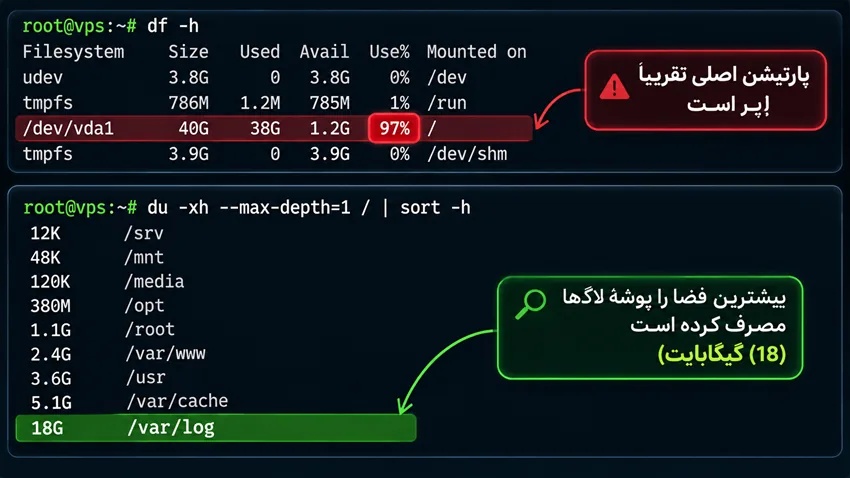
با df -h فضای پارتیشنها را ببینید. اگر چیزی نزدیک ۱۰۰ درصد است، علت کندی و خطاهای عجیب همین است — دیسک پر یعنی دیتابیس نمیتواند بنویسد، لاگ نوشته نمیشود و وبسرور خطا میدهد.
برای پیدا کردن اینکه فضا کجا رفته، از ریشه شروع کنید و لایهلایه جلو بروید: du -xh --max-depth=1 / | sort -h و بعد همین دستور را روی سنگینترین پوشه تکرار کنید. چهار جایی که در عمل بیشترین فضا را میگیرند: لاگها در /var/log، بکاپهای فراموششده، کش برنامه، و ایمیجها و کانتینرهای بیاستفادهٔ داکر.
یک تله: اگر فایلی را حذف کردهاید ولی فضا آزاد نشده، احتمالاً فرایندی هنوز آن فایل را باز نگه داشته. با lsof | grep deleted پیدایش کنید؛ ریاستارت همان سرویس فضا را آزاد میکند.
حالت کمتکرار ولی گیجکننده: فضا هست ولی خطای no space میگیرید. در این حالت inodeها تمام شدهاند، که با df -i دیده میشود و علتش معمولاً میلیونها فایل ریز کش است.
اگر هیچکدام پر نیست
اگر پردازنده، رم و دیسک سالماند و سرویس هنوز کند است، گلوگاه بیرون از این چهار منبع است:
- شبکه. اگر تأخیر مسیر و پینگ سرور مجازی بالاست، همهٔ درخواستها کند دیده میشوند در حالی که سرور بیکار است. تفکیکش ساده است: پینگ خوب و سرویس کند یعنی مشکل سرور است؛ پینگ بد یعنی نیاز به عیبیابی مسیر شبکه.
- دیتابیس. یک کوئری بدون ایندکس میتواند همهچیز را کند کند بدون اینکه منابع اشباع شوند. لاگ کوئریهای کند را فعال کنید.
- محدودیت تعداد اتصال. وبسرور یا دیتابیس به سقف کانکشن رسیده و بقیه در صفاند. این در لاگ دیده میشود، نه در htop.
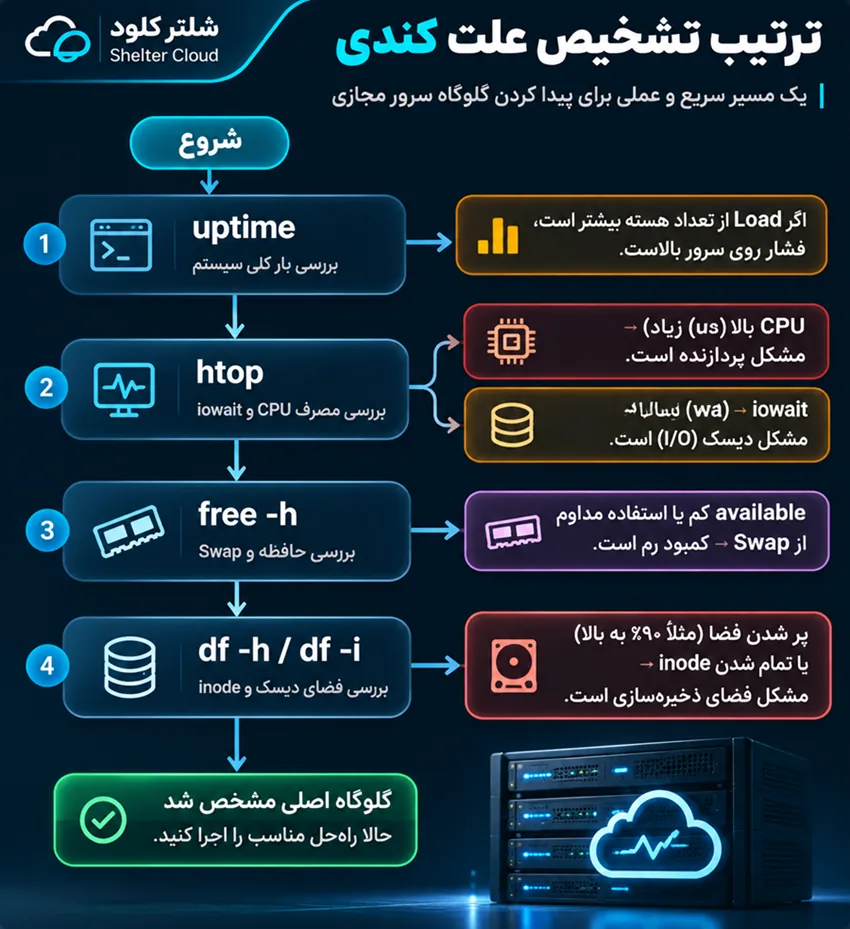
ترتیب تشخیص در یک جدول
| دستور | چه چیزی را رد یا تأیید میکند | نشانهٔ مشکل |
|---|---|---|
uptime | وجود فشار کلی | لود بیشتر از تعداد هسته |
htop | CPU یا دیسک | iowait بالا یا یک فرایند روی ۱۰۰ درصد |
free -h | رم | available کم و swap در حال استفاده |
df -h و df -i | فضا و inode | نزدیک ۱۰۰ درصد |
dmesg -T | grep -i oom | کشته شدن فرایند | هر خط OOM |
| لاگ و عیبیابی سرویس | علت واقعی | خطای تکرارشونده در زمان شروع مشکل |
کاری که قبل از مشکل بعدی انجام دهید
عیبیابی بعدی بهشرطی سریع خواهد بود که بدانید وضعیت عادی سرور شما چه شکلی است. لود معمول، مصرف رم معمول و فضای آزاد معمول را یک بار ثبت کنید؛ بدون این مبنا، هر عددی ممکن است نگرانکننده به نظر برسد یا برعکس.
قدم بعدی طبیعی این است که این اعداد بهصورت خودکار پایش شوند و وقتی از حد گذشتند خبر بدهند، نه اینکه بعد از قطعی متوجه شوید.
و اگر تشخیص نشان داد پلن فعلی برای بار واقعی کم آورده، منابع را بالا ببرید: در سرور ابری میتوانید رم، پردازنده و دیسک را بدون ساخت سرویس تازه افزایش دهید. برای فهم اینکه هر منبع چه نقشی دارد، سرور مجازی چیست تصویر پایه را میدهد.